개요
주요 요점
- 탄력 컴퓨팅은 수요 변동에 따라 컴퓨팅, 메모리, 저장 공간을 동적으로 확장하여 수작업의 관리 개입을 제거합니다.
- 수요가 줄어들 때 유휴 자원을 디프로비저닝하는 것은 확장만큼이나 중요합니다; 축소 효율성은 클라우드 비용 절감을 직접적으로 결정합니다.
- "탄성 컴퓨팅"과 "클라우드 탄력성"은 동일한 운영 능력을 의미하며, 엔터프라이즈 클라우드 아키텍처 전반에 걸쳐 상호 교환 가능하게 사용됩니다.
- 탄력성은 버스팅, 계절적, 임시방편 AI/분석 작업에서 최대 ROI를 제공합니다. 지속적이고 안정적인 보고 작업은 훨씬 적은 이익을 얻습니다.
- 하드 스케일링 제한, 실시간 텔레메트리, 부서 단위 비용 귀속이 없으면, 동적 자동 스케일링은 관리되지 않은 운영 비용을 초래할 수 있습니다.
탄성 컴퓨팅의 정의
전통적인 기업 용량 계획은 정적 예측에 의존합니다: 인프라 팀은 피크 리소스 요구량을 추정하고, 피크를 커버하기 위해 물리적 하드웨어나 예약 인스턴스를 구매하며, 비피크 기간 동안 유휴 용량의 재정적 비용을 흡수합니다.
탄성 컴퓨팅은 정적 예측을 지속적인 운영 피드백 루프로 대체합니다. 클라우드 플랫폼은 활성 워크로드 텔레메트리를 모니터링하고 실시간으로 자원을 동적으로 제공하거나 해제합니다.
진정한 탄력 컴퓨팅과 정적 예약 인프라를 구분하는 두 가지 특징이 있습니다.
- 자동화: 자원 조정은 실시간 활용 트리거에 기반한 프로그램적 조정으로 이루어지며, 인간의 개입이 전혀 필요하지 않습니다.
- 양방향성: 쿼리 동시성이 감소하면 자동으로 용량이 축소되어 가변적인 클라우드 인프라 비용을 직접 억제합니다.
클라우드 데이터 웨어하우징, 데이터 레이크하우스, 엔터프라이즈 분석 전반에 걸쳐 이러한 아키텍처적 특성은 클라우드 탄력성(cloud elasticity)이라고도 불립니다. 두 용어 모두 실시간 처리 수요와 컴퓨팅 공급을 맞추는 근본 메커니즘을 설명합니다.
탄성 컴퓨팅 작동 원리
실제로 확장 가능한 것은 무엇인가요
기업용 데이터 플랫폼과 AI 아키텍처에서 탄력성은 세 개의 뚜렷한 인프라 계층에 걸쳐 있으며, 각 계층은 서로 다른 속도로 조정됩니다.
- 컴퓨트: 고립된 가상 노드나 실행 클러스터를 통해 프로비저닝된 처리 용량. 컴퓨트는 가장 빠르게 조정이 가능한 계층이며, 워크로드 급증을 관리하는 주요 다이얼 역할을 합니다.
- 메모리: 컴퓨트 인스턴스와 함께 확장되는 시스템 RAM은 복잡한 해석적 조인, 고동시성 벡터 탐색, 분산 머신러닝 알고리즘의 운영 병목 현상이 되는 경우가 많습니다.
- 스토리지: 현대 클라우드 데이터 아키텍처는 컴퓨트와 스토리지를 분리하여 공유 객체 저장소 계층을 활용합니다. 이 분리는 컴퓨팅 자원이 재분할되거나 Teradata 데이터베이스 내에서 기본 데이터 세트를 물리적으로 이동하지 않고도 동적으로 확장과 축소가 가능하도록 합니다.
스케일링 이벤트를 유발하는 요소
확장 동작은 시스템 수준의 모니터링 엔진에 의해 관리되며, 사전 정의된 정책 임계값에 따른 운영 지표를 추적합니다. 일반적인 운영 트리거는 다음과 같습니다:
- 정의된 한도를 초과하는 지속적 CPU 또는 노드 사용률(예: 3분 시간 동안 85% 사용률).
- 예기치 않은 트래픽 급증 시 쿼리 큐 깊이 증가 또는 동시성 제한.
- 스트리밍 데이터 수집 파이프라인이나 실시간 API 요청이 급증하는 경우.
- Teradata 데이터베이스의 데이터베이스 내 분석 기능을 통해 시작되는 고동시성 모델 점수 부여, 특징 엔지니어링, 또는 에이전트 워크플로우 가 포함됩니다.
엔터프라이즈 플랫폼은 시스템 관리자가 명확한 상한선과 하한값을 설정할 수 있게 하여, 자동 확장이 사전 승인된 매개변수 내에서 엄격히 작동하도록 보장합니다.
규모를 줄이는 게 더 어려운 부분이에요
수요 급증 시 용량 확장은 간단합니다; 수축은 클라우드 경제적 ROI의 승패가 결정되는 지점입니다. 컴퓨팅 노드가 너무 과도하게 디프로비저빙하면 이후 쿼리 버스트에서 콜드 스타트 지연이 발생합니다. 노드가 실행 완료 후에도 오랫동안 프로비저닝 상태로 남아 있으면, 예상했던 클라우드 비용 절감은 빠르게 사라집니다.
경영진의 84%가 클라우드 지출 관리를 주요 운영 장애물로 꼽고 있어, 효과적인 노드 해체 정책이 매우 중요합니다. 인스턴스 프로비저닝, 노드 해체, 워크로드 격리에 대한 심층적인 운영 개요는 About Teradata Elastic Compute 문서를 검토하세요.
탄성 컴퓨팅의 실제 사례
일일 거래량에 맞춘 엔터프라이즈 분석을 운영하는 글로벌 소매 조직을 생각해 보십시오. 연례 프로모션 이벤트 중에는 공급망, 마케팅, 재고, 고객 경험팀이 동시에 임시 분석 쿼리를 수행하면서 동시 사용자 트래픽이 10배로 급증합니다. 동시에 자동화된 추천 모델도 비수야 야간 배치가 아닌 연속적으로 실행됩니다.
탄력 컴퓨팅이 없으면 기업은 두 가지 비용이 많이 드는 선택지에 직면한다.
- 과잉 제공: 최고 프로모션 볼륨에 맞춘 인프라 규모를 영구적으로 조정하면 표준 영업 주간에 최대 70%의 컴퓨팅 용량이 대비 상태로 남습니다.
- 공급 부족: 중앙 일일 수요에 맞춘 인프라 규모는 쿼리 큐 타임아웃, 포털 성능 저하, 그리고 홍보 피크 시간대의 잠재적 수익 손실을 초래합니다.
하지만 탄력적인 클라우드 아키텍처를 통해 독립적인 컴퓨트 클러스터는 쿼리 동시성이 쌓일 때 자동으로 확장되고, 피크 시간대에는 처리량을 유지하며, 트래픽이 정상화되면 자동으로 종료됩니다. 기업은 활성 운영 시간 동안에만 높은 컴퓨팅 용량에 대해 비용을 지불합니다.
탄력성과 확장성은 같은 것이 아닙니다
종종 동의어로 사용되지만, 확장성과 탄력성은 근본적으로 다른 공학적 목표를 다룹니다:
| 특징 차원 | 확장성 | 탄성 |
|---|---|---|
| 주요 초점 | 누적 업무량 증가를 감당할 수 있는 구조적 최대 용량. | 자원의 실시간 속도와 자동화된 확장과 수축. |
| 조정 모델 | 용량 추가(더 큰 하드웨어를 통한 수직 또는 추가 노드를 통한 수평 확장). | 동적 정책 기반 자동 프로비저닝과 자동 디프로비저닝. |
| 운영 목표 | 장기적이고 예측 가능한 비즈니스 및 데이터 볼륨 확장을 지원합니다. | 단기적이고 변동하는 수요 급증에 맞춰 유휴 하드웨어에 과도한 비용을 지불하지 않는 것. |
| 프로비저닝 속도 | 몇 분에서 며칠까지 (종종 수동 관리자 프로비저닝이나 조달이 포함됨). | 몇 초에서 분까지(시스템 텔레메트리 트리거에 의해 자동으로 구동됨). |
시스템은 탄력적이지 않아도 매우 확장 가능할 수 있습니다. 온프레미스 데이터 웨어하우스 는 종종 페타바이트 단위의 저장 공간까지 확장되지만, 컴퓨팅 용량을 추가하려면 하드웨어 확보와 영구 설치가 필요합니다.
포괄적인 비교 분석을 원한다면, 클라우드 탄력성과 클라우드 확장성에 관한 상세 가이드를 참고하세요.
탄력 컴퓨팅이 효과를 발휘하는 부분
- 폭발적이고 예측 불가능한 작업 부적: 애플리케이션이 기준선과 피크 자원 수요 사이에 상당한 변동을 겪을 때, 조직은 주문형 컴퓨팅 할당을 구현함으로써 즉각적인 재정적 수익을 얻을 수 있습니다.
- 데이터 과학, AI, 모델 학습: 머신러닝 모델 학습, 검색 증강 생성(RAG) 벡터 탐색 실행, 임시 데이터 과학 탐색 실행은 제한된 기간 동안 대규모 컴퓨팅이 필요합니다. 탄성 컴퓨트 클러스터는 팀이 전용 노드를 실행하고 완료 즉시 종료할 수 있도록 합니다.
- 계절별 및 이벤트 기반 처리: 월별 재무 마감, 분기별 규제 제출, 프로모션 소매 판매는 예측 가능한 급증을 만들어내며, 이는 영구적인 하드웨어 확장보다는 동적 배분이 가장 효과적입니다. 이러한 패턴은 이미 작년 수치에 문서화되어 있어 가장 쉽게 정당화할 수 있는 탄력성 사례입니다.
기업 관련 고려사항
비용 예측 가능성과 가드레일
최근 기업 연구에 따르면 퍼블릭 클라우드 인프라 지출의 29%가 낭비로 손실되고 있으며, 이는 주로 관리되지 않은 컴퓨팅 확장과 유휴 개발자 환경 때문입니다. 예산 예측 가능성을 유지하기 위해 FinOps 팀은 명확한 인프라 가드레일을 강제해야 합니다: 소비 기반 클라우드 가격 모델은 지출을 가시화하고, 워크로드 수준 비용 추정 은 특정 조합이 프로비저빙되기 전 실제로 얼마가 들었는지 보여줍니다.
이러한 인프라 가드레일을 고려해 보십시오.
- 정의된 확장 범위: 쿼리 이상 현상 시 컴퓨팅 낭비를 방지하기 위해 자동 확장 인스턴스 생성에 엄격한 상한과 하한을 설정하는 것.
- 실시간 텔레메트리 및 알림: 확장 이벤트를 기록하여 플랫폼 관리자가 자원 확장이 왜 발생하는지 즉시 파악할 수 있습니다.
- 비용 귀속 및 쇼백: 부서, 프로젝트 또는 사업부별로 동적 컴퓨팅 인스턴스를 태그하여 재무 책임성을 강화합니다.
거버넌스 및 접근 통제
거버넌스되지 않는 자동 확장은 운영 및 보안 위험을 초래합니다. 기업 클라우드 배포는 역할 기반 접근 제어(RBAC)를 강제하고, 데이터 암호화 정책이 동적 컴퓨트 클러스터에 자동으로 확장되도록 하며, 준수 감사를 위해 모든 확장 이벤트를 기록해야 합니다.
탄성이 잘못된 답일 때
탄력적 컴퓨팅은 모든 기업 워크로드 프로필에 보편적인 해결책이 아니며, 이러한 상황에서는 적합하지 않을 수 있습니다.
- 예측 가능한 기준선 처리: 고정적이고 높은 활용률로 실행되는 핵심 엔터프라이즈 데이터 웨어하우스 쿼리 는 전용 예약된 컴퓨팅 용량에서 훨씬 비용 효율적으로 작동합니다.
- 초저지연 SLA: 새로운 컴퓨트 노드를 가동하는 데 필요한 짧은 초기화 지연을 견딜 수 없는 워크로드는 사전 할당된 항상 연결된 인프라가 필요합니다.
- 스토리지 또는 I/O 바운드 병목 현상: 네트워크 처리량이나 스토리지 디스크 I/O로 병목 처리된 애플리케이션에 컴퓨트 클러스터를 추가해도 실행 속도는 향상되지 않습니다.
전용 기본 인프라와 동적 컴퓨팅 간의 구조적 절충을 평가하기 위해, The Always-On Reality에 대한 분석을 살펴보십시오.
테라데이터에서의 탄성 컴퓨팅
현대 기업 데이터 아키텍처는 예측 불가능하고 고동시성 분석과 함께 정상 상태 비즈니스 보고를 지원해야 합니다. Teradata Cloud 는 두 컴퓨트 모델을 단일 워크로드 관리 프레임워크 아래 통합합니다:
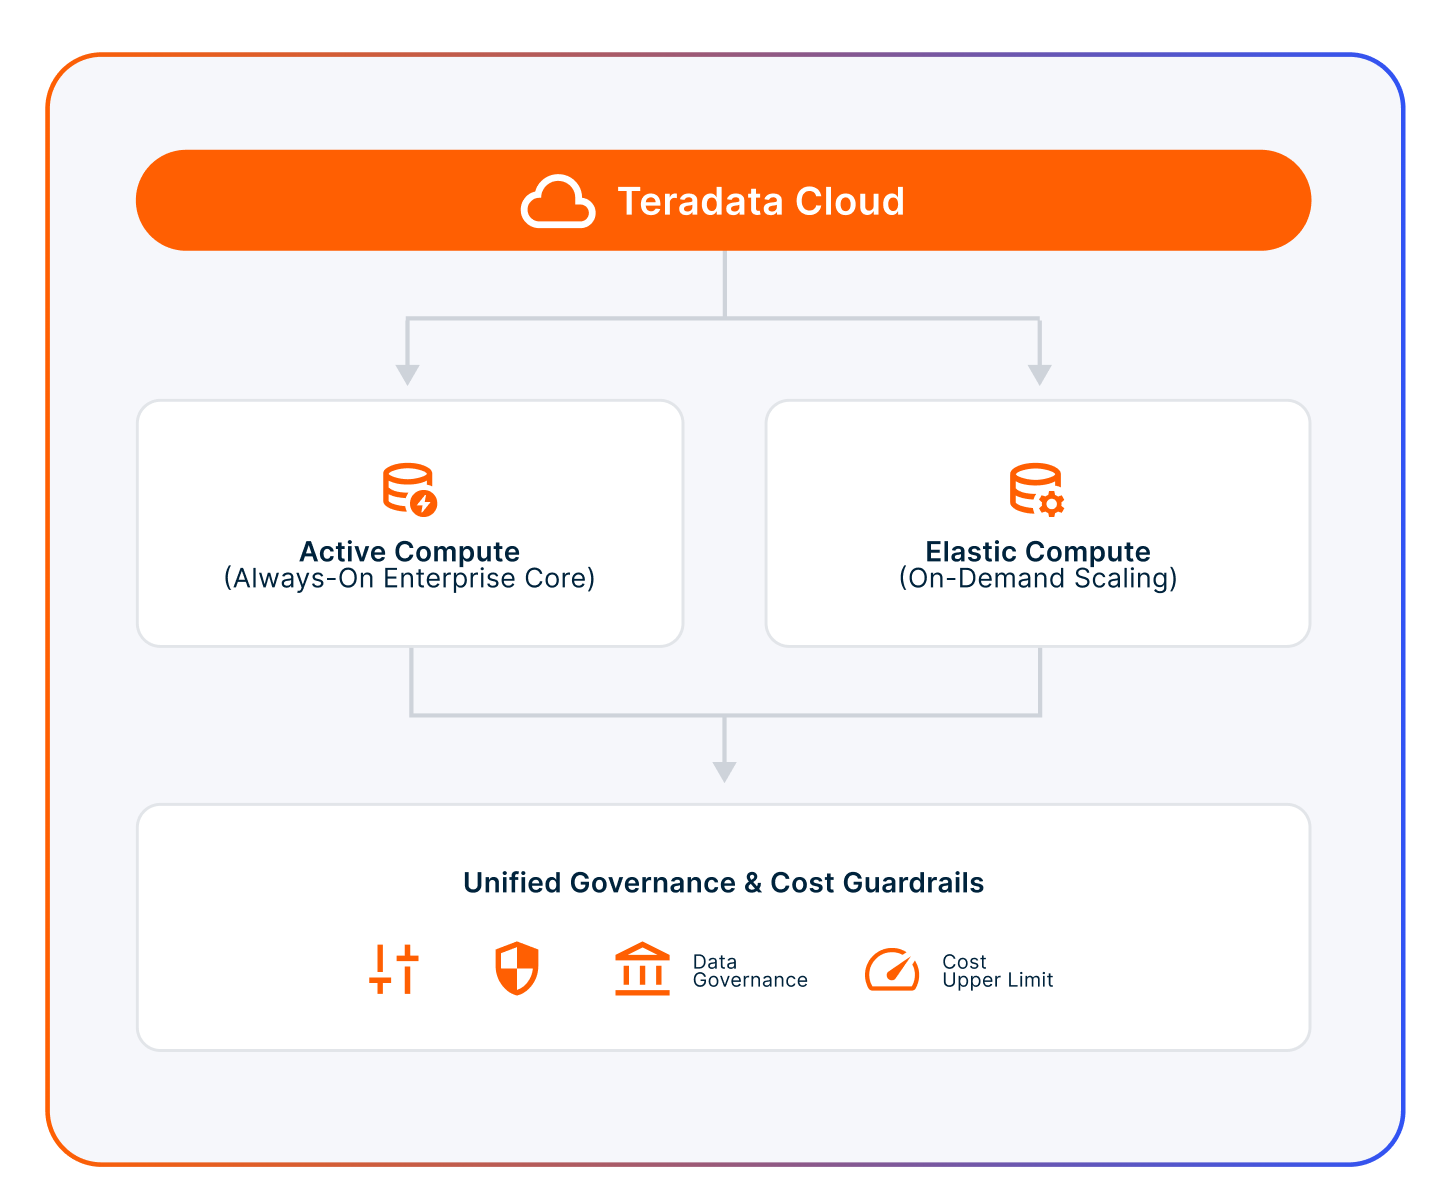
- Teradata 액티브 컴퓨트: 예측 가능한 엔터프라이즈 데이터 웨어하우징, 운영 보고 및 코어 대시보드를 위한 항상 온라인의 전용 컴퓨트 노드를 안정적인 속도로 제공합니다.
- Teradata 탄력적 컴퓨팅: 탐색적 데이터 과학, 임시 부서 분석, AI 모델 실행을 위한 동적 온디맨드 컴퓨트 클러스터 확장성을 제공합니다. 이 격리된 클러스터들은 Iceberg, Delta와 같은 오픈 테이블 포맷 등 기본 객체 저장소와 독립적으로 확장되며, 워크로드가 종료되면 자동으로 디프로비저빙됩니다.
통합 워크로드 관리 하에서 능동적 컴퓨팅과 탄력적 컴퓨팅을 조정함으로써, 기업 조직은 자원 경쟁을 없애고 엄격한 비용 상한을 유지하며 인프라를 과도하게 제공하지 않고 지속적인 분석을 지원합니다.
AWS, Microsoft Azure, Google Cloud 전반에 걸쳐 플랫폼이 배포되는 모든 곳에 동일한 워크로드 관리가 적용됩니다.
결론
탄력 컴퓨팅은 현대 기업들이 클라우드 분석을 설계하고 비용을 지불하는 방식을 재정의했습니다. 컴퓨팅 공급과 처리 수요를 실시간으로 동적으로 매칭함으로써, 조직은 짧은 사용량 급증을 위해 고가의 인프라를 과잉 배치할 필요를 없애줍니다. 하지만 클라우드 탄력성의 진정한 재무적 이점을 포착하려면 의도적인 운영 거버넌스가 필요합니다. 엄격한 확장 상한선, 실시간 텔레메트리, 명확한 비용 귀속이 없으면 자동 확장 기능은 클라우드 비용 낭비를 빠르게 악화시킬 수 있습니다.
가장 효과적인 엔터프라이즈 데이터 전략은 탄력적 확장과 전용 기준선 컴퓨팅을 결합하여, 변동형 분석과 AI 워크로드가 필요에 따라 확장되도록 하고, 정상 상태 보고는 최대 비용 효율성으로 예측 가능하게 실행되도록 보장합니다.
클라우드 데이터 아키텍처를 최적화할 준비가 되셨나요?
확장 가능하고 비용 통제 가능한 데이터 기반을 구축하세요
Teradata 자율 지식 플랫폼에서 예측 가능한 엔터프라이즈 워크로드와 동적 온디맨드 확장 간의 균형을 배우는 방법을 알아보세요. Teradata Cloud를 탐색하거나 About Teradata Elastic Compute 문서를 검토하여 비용 통제가 통제되고 고도로 확장 가능한 데이터 인프라를 구축하세요.
자주 묻는 질문
What is an example of elastic computing?
What is an example of elastic computing?
A clear example is a retail data platform that automatically provisions additional compute clusters as query volume surges during peak promotional events, then de-provisions those clusters when demand normalizes—ensuring the company pays only for active compute hours.
What do you mean by elastic computing?
What do you mean by elastic computing?
Elastic computing refers to cloud platform capabilities that automatically provision and de-provision compute, memory, and storage resources in real time based on fluctuating operational demand.
What is the difference between elasticity and scalability?
What is the difference between elasticity and scalability?
Scalability is a system’s maximum structural capacity to handle long-term growth by adding resources over time. Elasticity is a system’s capability to automatically expand and shrink capacity in real time to match fluctuating demand.
Is elastic computing the same as cloud elasticity?
Is elastic computing the same as cloud elasticity?
Yes. Across enterprise cloud architecture, data engineering, and FinOps, “elastic computing” and “cloud elasticity” are synonymous terms used to describe automated compute scaling.